introducing Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS, our most expressive audio generation models yet
— Google AI Studio (@GoogleAIStudio) September 23, 2026
these models enable creators, developers, and enterprises to create richer, more expressive audio experiences
try them via the Gemini API and in AI Studio:… pic.twitter.com/vV84ErmKY1
出典:X(@GoogleAIStudio)
Googleは2026年9月23日、テキストから音声を生成する「Gemini 3.8 Flash TTS」と「Gemini 3.8 Flash-Lite TTS」を発表しました。声のカスタマイズやセリフごとの演出に対応する、2つのモデルの特徴を紹介します。
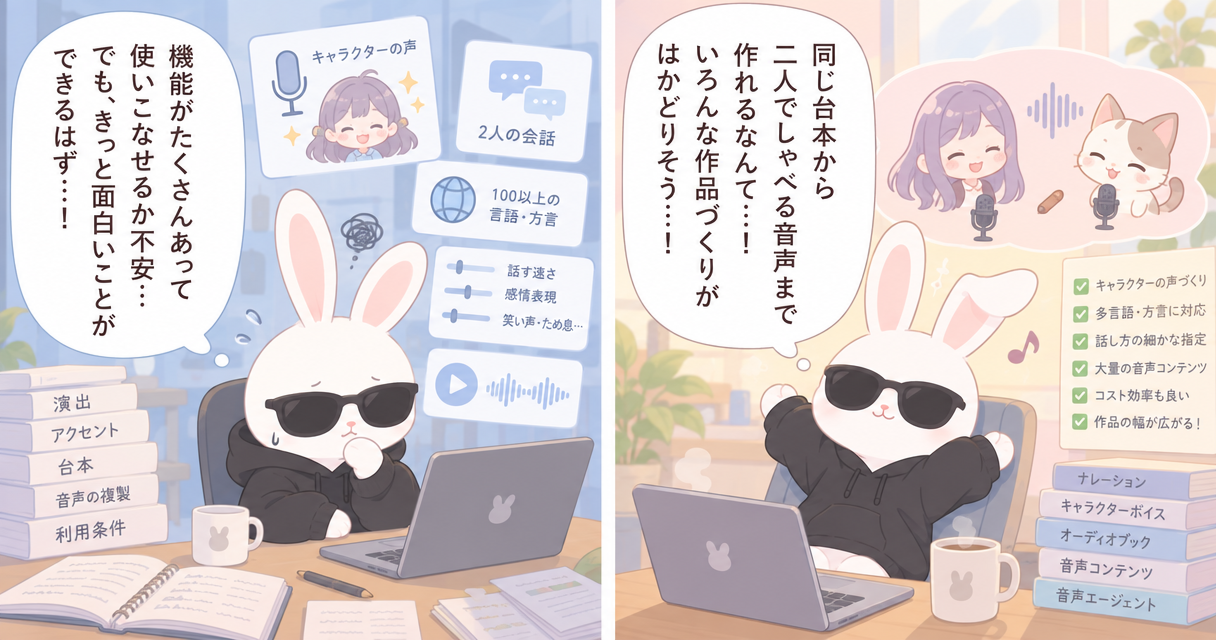
- Flash TTSは、自然言語による声の設計やセリフごとの細かな演出に対応
- Flash-Lite TTSは、大量の吹き替えや音声コンテンツ制作などを想定
- 音声複製には声の持ち主による口頭の同意録音が必要。生成音声にはSynthIDの透かしを付与
- 両モデルはGemini APIとGoogle AI Studioで提供を開始
目的の異なる2つの音声生成モデル
「Gemini 3.8 Flash TTS」は、キャラクターの声づくりや音声表現の細かな演出を重視したモデルです。自然言語の指示を使い、役柄、アクセント、声の特徴を指定して新しい声を作れます。Googleによると、100以上の言語・方言にわたって声を設計でき、2,000以上の声を収録したライブラリも利用できます。
一方、「Gemini 3.8 Flash-Lite TTS」は、大量の吹き替えや音声コンテンツの制作、音声エージェントなどに向けたモデルです。大量利用時のコスト効率を重視しながら、声のトーンや話す速さなどを調整できます。
セリフ単位で演出を指定
両モデルは、セリフごとに話し方を指示できます。台本に演出指示を書き込み、ペースや感情表現を調整できるほか、笑い声やため息、相づちといった要素も加えられます。1つの台本から、2人の話者による会話を生成する機能にも対応します。
Flash TTSでは、自分の声、または利用する権利のある声の30秒の音声サンプルから、声の特徴を再現できます。また、作成したカスタム音声を保存・管理できます。
音声複製には同意確認、生成音声には透かし
Googleは、音声を複製する際には、参照音声の話者と一致する声の持ち主による、口頭の同意録音が必要だと説明しています。また、Gemini Audioモデルが生成するすべての音声には、AI生成音声であることを検出できるよう、SynthIDの透かしを付与します。
提供先はモデルごとに異なる
両モデルは、開発者向けにGemini APIとGoogle AI Studioで提供が始まります。企業向けには、Gemini EnterpriseのAPIを通じて今後提供する予定です。
一般向けの提供先は異なり、Flash TTSはGemini Notebook、Flash-Lite TTSはGoogle Vidsで利用できます。なお、Google AI Studioでの音声複製機能は、イリノイ州、テキサス州、欧州経済領域(EEA)、英国、スイス、インドでは利用できません。
