Please welcome GPT-6 Sol and GPT-6 Luna to the GPT-6 universe.
— OpenAI (@OpenAI) September 22, 2026
GPT-6 Sol and Luna build on the advances behind GPT-6 Astra, bringing much of its strengths into faster and more affordable models to support work at scale.
We’ve also made caching and inference more efficient, and… pic.twitter.com/5LiVE4rbFt
出典:X(@OpenAI)
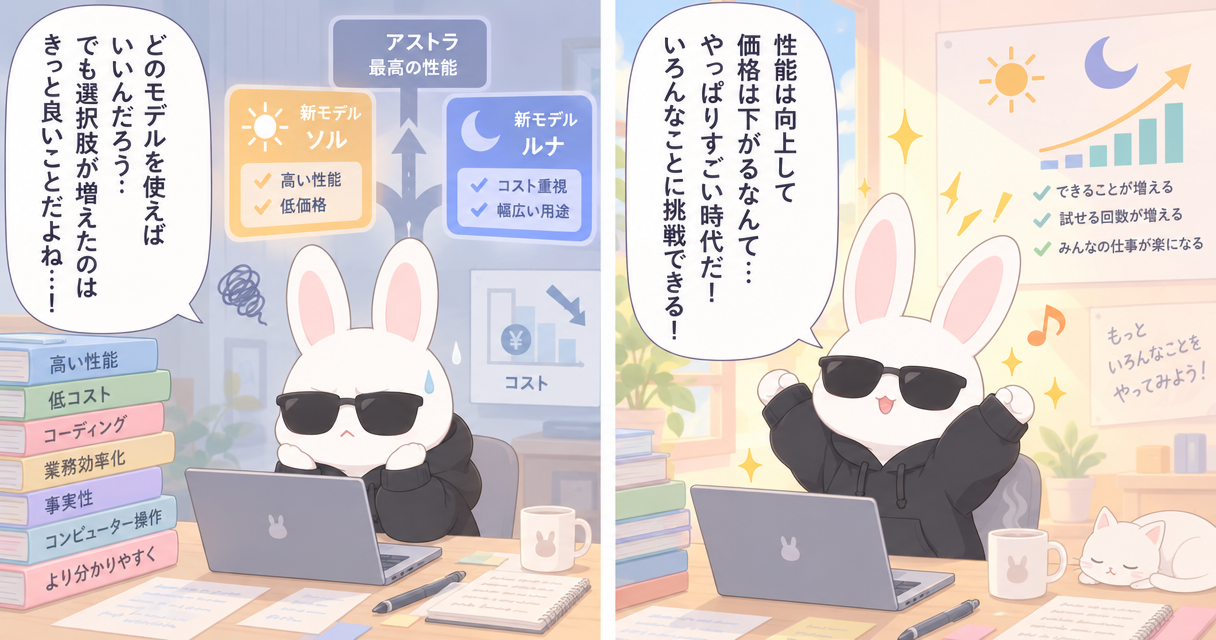
OpenAIは、GPT-6シリーズの新モデル「GPT-6 Sol」と「GPT-6 Luna」を発表しました。GPT-6 Astraの技術的進歩を、より高速かつ低価格なモデルへ展開したものです。OpenAIによると、API価格はGPT-5.6のプロモーション価格から50%引き下げられ、業務、事実性、コーディング、コンピューター操作なども強化されています。
- GPT-6 SolとLunaは、GPT-6 Astraと同様の手法でトレーニングされた高速・低価格モデル
- OpenAIによると、API価格はGPT-5.6のプロモーション価格と比べて50%低下
- 業務、事実性、コーディング、コンピューター操作、コミュニケーションスタイルを改善
- GPT-6のプロンプトキャッシュを改良し、キャッシュ済み入力トークンの読み取りには90%の割引を適用
- ChatGPT WorkとCodex、OpenAI APIなどで提供
GPT-6シリーズにSolとLunaが追加
OpenAIは、GPT-6シリーズへ「GPT-6 Sol」と「GPT-6 Luna」を追加しました。
同社は先に、総合的に最も優れたモデルとしてGPT-6 Astraを発表しています。特に要求水準の高い重要なプロジェクトにはAstraが適する一方、実際の業務では規模、作業ペース、予算が異なります。SolとLunaは、そうした幅広い用途にGPT-6世代の能力を提供するためのモデルです。
両モデルはGPT-6 Astraと同様の手法でトレーニングされ、Astraが示した専門業務、事実性、コーディング、コンピューター操作、アラインメントの進歩を、より高速で低価格なモデルへ取り入れています。
API価格を引き下げ
キャッシュと推論の改善により、OpenAIはGPT-6 SolとLunaのAPI価格をGPT-5.6のプロモーション価格から50%引き下げたと説明しています。公表された価格は次のとおりで、いずれも100万トークン当たりです。
| モデル | 入力 | 出力 |
|---|---|---|
| GPT-5.6 Sol | 4ドル | 20ドル |
| GPT-6 Sol | 2ドル | 10ドル |
| GPT-5.6 Luna | 0.20ドル | 1.20ドル |
| GPT-6 Luna | 0.10ドル | 0.50ドル |
OpenAIは、こうした価格と基盤の改善によって、高度なAIを日常的な作業や大規模なアプリケーションへ導入しやすくなると説明しています。
なお、GPT-6 Astraは引き続き、総合的に最も優れたモデルと位置付けられています。最高の結果と妥協のない体験を求める場合にはAstraが推奨されています。
複雑な業務を低コストで処理
GPT-6 Solは、難しい業務に対応しながら、低価格と高い利用上限によって試行を重ねやすいモデルです。
複数のアプリをまたぐ業務フローを評価する「AutomationBench 1.0.6」では、47種類のツールを使い、営業、マーケティング、オペレーション、サポート、財務、人事のエンドツーエンド業務をテストしています。
GPT-6 Solのxhigh effortは33.2%を記録し、Claude Opus 5のmax effortにおける26.9%を上回りました。1タスク当たりのコストは0.27ドルで、Claude Opus 5の約9%です。また、GPT-6 Astraのlow effortによる30.3%も上回っています。
GPT-6 Lunaのhigh effortは、前モデルより5.4ポイント向上し、1タスク当たりのコストは58%低下しました。
複雑な専門業務を評価する「Agents’ Last Exam V1」では、GPT-6 Solのmax effortが56.4%を記録しました。評価内におけるClaude Opus 5の最高スコアを上回りながら、1タスク当たりのコストは60%低くなっています。
事実性を改善
OpenAIは、利用者が過去のモデルによる誤りを指摘した、匿名化済みの実際の会話をもとに社内評価を実施しています。
この評価では、GPT-6 Solの誤りが前モデルのおよそ半分となり、より低いコストでGPT-6 Astraに近い信頼性を示しました。GPT-6 Lunaも改善し、高いeffortではGPT-5.6 Solと同等の結果を約100分の1のコストで達成しています。
ただし、この評価には事実誤認を引き起こした会話が使われており、誤りがより少ない一般的な利用状況を代表するものではありません。また、スコアは回答の長さについて調整されていません。
コーディング性能とコスト効率を向上
GPT-6 SolとLunaは、コーディング性能と低いAPI価格を組み合わせ、開発者がより多くの試行を行えるようにしています。
実際のコードベースへ統合できる変更を作れるか評価する「FrontierCode 1.1 Main」では、GPT-6 SolがGPT-5.6 Solから大きく向上し、より低いコストでClaude Fable 5.1のxhigh effortと同等の結果を示しました。この評価では、正確性だけでなく、テスト品質、変更範囲の適切さ、コードスタイル、コードベースの基準への準拠も採点されます。
長期的で複雑なソフトウェアエンジニアリング作業を扱う「DeepSWE v1.1」では、次の結果が示されています。
- GPT-6 Solのmax effort:68.8%
- Claude Fable 5のxhigh effort:69.9%
- GPT-6 Lunaのmax effort:66.6%
GPT-6 SolはClaude Fable 5の最高スコアとの差が1.1ポイントで、1タスク当たりのコストは約80%低くなっています。GPT-6 LunaはClaude Opus 5およびFable 5のmedium effortと同程度の結果を示し、コストはOpus 5より93%、Fable 5より96%低くなっています。
コンピューター操作も効率化
OpenAIはGPT-6 Astraをコンピューター操作で最も優れたモデルと位置付けていますが、SolとLunaも前モデルより高いコスト効率を実現しています。
日常業務と専門業務にまたがる長期的なコンピューター操作を評価する「OSWorld 2.0 offline」では、GPT-6 Solのxhigh effortが60.5%を記録しました。Claude Opus 5のmedium effortによる60.3%と近い結果で、1タスク当たりのコストは約80%低くなっています。
GPT-6 Lunaのmax effortは、GPT-5.6 Solのmedium effortを上回り、コストは10分の1でした。
より簡潔で明確なコミュニケーションへ
SolとLunaには、GPT-6 Astraで改善されたコミュニケーションスタイルも取り入れられています。OpenAIは、特に技術やコーディングに関する会話で、次の変化が見込まれると説明しています。
- 表現がより明確になる
- 専門用語を抑える
- 不自然な言い回しを減らす
- 価値の低い詳細を省く
- 内容を損なわず、回答をやや短くする
OpenAIが示したウェブサイト変更の例では、GPT-6 Solの回答について、早い段階で結論を出さず、依頼者にとって明白な詳細を繰り返さず、確認したことと確認していないことを率直に伝え、画像ツールのプロンプトなど不要な実装情報を共有しない点が評価されています。
プロンプトキャッシュを強化
GPT-6ではプロンプトキャッシュも改善されました。標準状態でキャッシュのヒット率を高め、エージェントが過去のコンテキストを再利用しやすくします。これにより応答を高速化し、キャッシュ済み入力トークンの読み取りには90%の割引が適用されます。
開発者向けには、次の管理・最適化手段が用意されています。
- 監視と診断:Prompt Caching Dashboardでキャッシュされた入力の量と推移を確認でき、診断ツールでキャッシュできなかった原因や改善点を調べられる
- 設定変更時のキャッシュ維持:推論effortや利用可能なツールを変更しても、以前のコンテキストをキャッシュとして再利用できる
- キャッシュ範囲の最適化:明示的なブレークポイントにより、キャッシュするプロンプトの接頭部分をどこで終えるか指定できる
GitHubによると、これらの改善によって、過去数カ月にわたる数十億件のOpenAIモデルへのリクエストで、新たに処理する必要があるプロンプトトークンの割合が50%以上減少し、Copilotの応答高速化につながりました。
アラインメントも継続的に改善
GPT-6 SolとLunaは、GPT-6 Astraで導入されたアラインメントの取り組みを引き継いでいます。OpenAIの評価では、両モデルがそれぞれのGPT-5.6版より改善し、コーディング作業について誤解を招く主張をする割合も低下しました。
ただし、この評価は不正直な挙動を引き出すために意図的に選ばれた難しい状況を扱うもので、一般的な利用時の失敗率を示すものではありません。
提供対象とAPIモデル名
発表時点で、GPT-6 SolとGPT-6 Lunaは、Plus、Pro、Business、Enterprise、Eduの全ユーザーを対象に、ChatGPT WorkとCodexで提供されています。
FreeおよびGoユーザーは、デスクトップアプリでGPT-6 Lunaを利用できます。一方、両モデルはまだChatでは提供されていません。
OpenAI APIでは、次のモデル名で利用できます。
gpt-6-solgpt-6-luna
サービスの安定性を保つため、ChatGPTでは発表日に段階的に展開されます。ChatGPT WorkやCodexで表示されない場合は、時間を置いて再度確認するよう案内されています。
なお、GPTの評価はOpenAIの研究環境またはAPIで行われています。システムプロンプトや利用可能なツールなどが異なるため、実際のChatGPTでは出力に差が生じる可能性があります。競合モデルの評価値には、公開済みのレポートが使われています。
