Introducing Fusion in Devin CLI
— Cognition (@cognition) September 11, 2026
The most efficient frontier harness for Fable & Astra; 39% cheaper across coding benchmarks.
Pick your favorite model for planning and a cost-effective model for execution. pic.twitter.com/rKVn6S7Hqu
Devin DesktopとCLIで、2つのモデルを組み合わせる「Fusion」が利用可能になりました。フロンティアモデルを計画・レビュー担当の「lead」、よりコスト効率の高いモデルを実行担当の「sidekick」として並列稼働させる構成です。主要なコーディングベンチマークでは、フロンティア性能を維持しながらコストを削減したとしています。
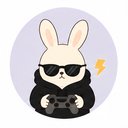
- Fusionでは、計画とレビューを担う「lead」と、実装やテストを担う「sidekick」の2モデルを選択する
- 2つのエージェントは、それぞれ独立した永続的なコンテキストとツールを持って並列稼働する
- Artificial Analysis Coding Agent Index v1.5では、Fable 5.1構成で36%、Astra構成で39%のコスト削減が示された
- モデルはトークン単価だけでなく、タスク全体を完了するためのコストで評価すべきだとしている
- 推奨構成はFable 5.1とSWE-2の組み合わせで、Devin CLIはインストールコマンドから試せる
FusionがDevin DesktopとCLIで利用可能に
「Fusion」は、FableとAstra向けのモデルハーネスです。今回、Devin DesktopとCLIで利用できるようになりました。
Fusionを選択する際は、1つではなく2つのモデルを指定します。
- lead:計画、曖昧さの解釈、レビューを担当するフロンティアモデル
- sidekick:コード調査、変更の実装、テスト、結果報告を担う、よりコスト効率の高いモデル
推奨されている組み合わせは、Fable 5.1をlead、SWE-2をsidekickにする構成です。
Artificial Analysisの指標で最大39%のコスト削減
Artificial Analysis Coding Agent Index v1.5では、Fusionとほかのモデルハーネスを比較した結果が示されています。
Fable 5.1では、Claude Codeのスコアが62.2、コストが12.36ドルだったのに対し、Devin FusionとSWE-2の構成はスコア61.7、コスト7.90ドルでした。コストは36%低い結果です。
Astraでは、Codexのスコアが61.6、コストが7.47ドルだったのに対し、Devin FusionとSWE-2の構成はスコア58.9、コスト4.54ドルでした。こちらは39%のコスト削減となっています。
複数のベンチマークで検証
Artificial AnalysisおよびVals AIとの検証では、Fable 5.1またはGPT-6 Astraをlead、SWE-2をsidekickとして、複数のコーディングエージェント向けベンチマークを評価しています。
Fable 5.1とFusionの比較
| ベンチマーク | Fable 5.1 | Fusion(Fable 5.1+SWE-2) | コスト削減率 |
|---|---|---|---|
| DeepSWE 1.1 | 64.3/$14.63 | 63.1/$7.88 | 46% |
| Terminal-Bench 4 | 57.6/$17.46 | 56.1/$13.37 | 23% |
| SWE-Atlas QnA | 64.8/$7.57 | 65.9/$5.00 | 34% |
| Vals Code Migration | 54.6/$70.97 | 57.3/$42.00 | 41% |
| FrontierCode 1.1 Extended | 63.6/$2.68 | 63.5/$1.67 | 38% |
AstraとFusionの比較
| ベンチマーク | Astra | Fusion(Astra+SWE-2) | コスト削減率 |
|---|---|---|---|
| DeepSWE 1.1 | 67.6/$7.88 | 67.3/$4.69 | 40% |
| Terminal-Bench 4 | 55.6/$10.08 | 50.0/$6.06 | 40% |
| SWE-Atlas QnA | 61.8/$5.72 | 59.4/$3.59 | 37% |
| Vals Code Migration | 67.7/$44.36 | 61.3/$35.51 | 20% |
| FrontierCode 1.1 Extended | 63.1/$2.62 | 63.4/$2.34 | 11% |
ベンチマークによってスコアの増減はありますが、すべての掲載結果でFusion構成のコストが低くなっています。
単純なモデルルーティングとは異なる設計
ソフトウェアエンジニアリングのすべての作業に、フロンティアモデルの能力が必要なわけではありません。そのため、簡単な作業を安価なモデルに任せ、難しい作業だけを高性能なモデルへ割り振るモデルルーティングが考えられます。
しかし、最初の指示だけではタスクの難易度を判断できない場合があります。「バグを修正する」という依頼でも、1行の修正で済む可能性がある一方、製品全体の再設計が必要になる可能性もあり、コードを調査するまで判別できません。
さらに、タスクの途中でモデルを切り替えるとプロンプトキャッシュが途切れ、フロンティアモデル側のコストが増える問題も挙げられています。
Fusionは単純にモデルを切り替えるのではなく、2つのエージェントを並列で動かします。それぞれが独自の永続的なコンテキストとツールを持つ点が特徴です。
leadとsidekickの役割分担
セッション全体を管理するのはleadです。leadは計画を立て、曖昧な点を解釈し、sidekickの成果をレビューします。作業を委任する際には、制約や成功条件を含む指示をsidekickへ渡します。
sidekickは、その指示に基づいて次の作業を担います。
- コードを調査する
- 変更を実装する
- テストを実行する
- 結果をleadへ報告する
両者の間で共有するのは、指示、結果、フィードバックです。会話履歴や途中のツール実行結果をすべて受け渡すわけではありません。それぞれのエージェントが独自のコンテキストを維持するため、プロンプトキャッシュを活用できます。
また、フロンティアモデルであるleadが常に成果を確認します。sidekickでは対応しきれない場合、問題を特定して主導権を取り戻せる構成です。利用者とのやり取りもleadが担当します。
高価なモデルがシステム全体を安くする場合も
Fusionの検証では、トークン単価が高いモデルを使うことで、システム全体のコストが下がる場合があるとしています。
例として、leadをOpus 4.8からFable 5へ変更した際、Fableのトークン単価は名目上2倍だったものの、同じsidekickを使ったセッションの平均コストは9%低下し、FrontierCodeのスコアも上昇しました。Fableは早い段階で作業を委任し、より良い指示を出した一方、Opusはsidekickを細かく管理し、その作業の多くをやり直したと説明されています。
sidekickについても、より強力なモデルは少ないターンとトークンで作業を完了できる傾向があります。実装の失敗が減れば、leadによるレビューや修正の回数も抑えられます。
AstraをleadにしたFrontierCodeの結果では、GPT-5.6 Lunaをsidekickにした構成がスコア62.0、コスト2.39ドルでした。SWE-2を使った構成は、SWE-2のリスト価格が275%高い一方、スコア63.4、コスト2.34ドルとなり、全体コストは2%低い結果でした。
この結果から、モデルやモデルハーネスはトークン単価ではなく、タスク単位の価格で評価すべきだとしています。
モデルの組み合わせごとにハーネスを調整
leadとsidekickを選ぶだけでは、それぞれのモデルから最良の結果を引き出せるとは限りません。Fusionでは、モデルの組み合わせに応じてハーネスを継続的に調整しています。
主な調整点は次の3つです。
leadが指示に含める詳細度
Fable 5.1を比較的弱いsidekickと組み合わせる場合、より具体的な指示が必要です。lead側のトークンは増えますが、その後のレビュー回数を減らせます。SWE-2との組み合わせでは、実装の詳細をsidekickの判断に任せられます。
sidekickが指示へ異議を唱える余地
強力なsidekickに異議申し立てを促すと、leadの計画にある誤りを見つけられる場合があります。一方、比較的弱いsidekickに意見を持たせすぎると、性能とコストの両方に悪影響が出るとしています。
どの調査を委任するか
計画に必要な調査は、その後の方針を左右するため、比較的弱いsidekickには任せない方針です。一方、強力なsidekickには初期調査の支援も促しています。この境界の調整は、現在も研究が続けられています。
