Introducing Atlas:
— World Labs (@theworldlabs) September 1, 2026
The world's first multimodal world model that generates image and video frames with pixel-perfect camera control and reconstructs them in 3D.
Model the world, move the camera, and simulate space & time. pic.twitter.com/o0qeGubi19
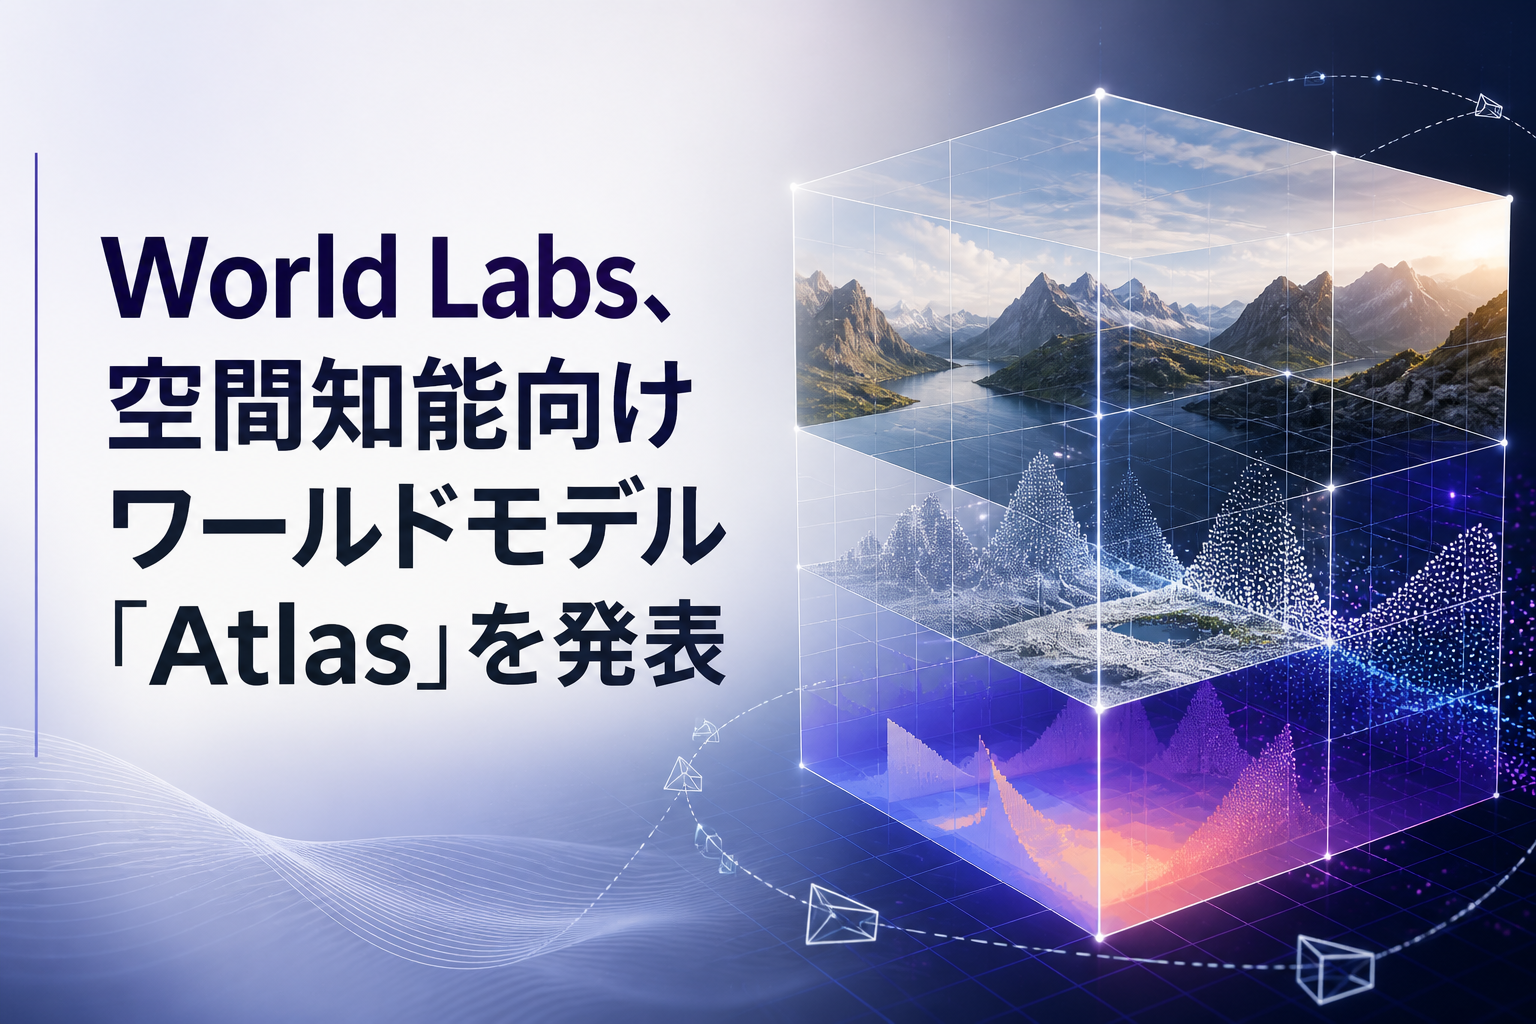
World Labsは2026年9月1日、空間知能向けワールドモデル「Atlas」を発表しました。テキスト、画像、動画、3Dを扱い、指定したカメラ経路に沿う動画生成、少数画像からの3D再構築、ロボット向けシミュレーションなどに対応します。
- Atlasは、テキスト、画像、動画、3Dを扱うマルチモーダルなワールドモデルです。
- 指定したカメラ経路に沿って、最大1分・1440pの動画を生成できます。
- 提供は選定されたパートナー向けの早期アクセスから始まります。
Atlasの主な機能
Atlasは、入力を3D空間に基づく共通の空間コンテキストとして処理し、世界の生成、再構築、シミュレーションを行います。
| 機能 | 内容 |
|---|---|
| カメラ制御付き生成 | 1枚以上の参照画像とカメラ位置・角度を基に、新しい視点の画像や動画を生成 |
| 長尺動画 | 手動で設計したカメラ経路に沿って、最大1分・1440pの動画を生成 |
| 空間再構築 | 1枚以上の画像から、新規視点のフレームや明示的な3Dデータを生成 |
| 時空間シミュレーション | 動画内の空間と時間をモデル化し、別視点へのリフレーミングやロボット向けReal-to-Simに利用 |
| 画像生成 | テキストから画像や360度パノラマを生成 |
Atlasは、カメラ情報を明示的なカメラ姿勢として受け取ります。これにより、生成時のカメラ位置、角度、移動経路を指定できます。
少数画像からの3D再構築
Atlasは、入力画像とカメラ姿勢を基に、新しい視点のフレームや奥行き情報を生成します。結果は2D画像や動画に加え、点群または3D Gaussian splatsとして出力できます。
Atlas also outputs explicit 3D from one to many input images, beating top open source reconstruction models.
— World Labs (@theworldlabs) September 1, 2026
Passing more images gives Atlas more context: the more it sees, the less it imagines. pic.twitter.com/5nB2eFC7UQ
入力に写っていない領域は、モデルの世界知識に基づいて補完されます。このため、少数画像から広い空間を生成できる一方、見えていない部分は実物の忠実な再現ではなく、モデルが推定した内容です。World Labsは、入力画像を増やすほどモデルが想像で補う範囲が減ると説明しています。
映像制作とロボットシミュレーション
映像では、3〜5台のカメラ映像からシーンを再構築し、時間を止めて別の角度から見たようなショットを生成できます。紹介例は、携帯電話やアクションカメラを使って撮影されています。
By positioning multiple input views within the model's spatial context, Atlas allows you to generate image and video frames with precise control.
— World Labs (@theworldlabs) September 1, 2026
Here, we hand-designed a camera trajectory to generate a 1 minute video at 1440p resolution from seven reference images. pic.twitter.com/dlDCHQWjfX
ロボット分野では、実環境を3Dで再構築し、シミュレーション内を移動するロボットのセンサーが観測するRGB画像と深度データを生成します。物体やその位置、ロボットの動き、照明、背景を変え、訓練データやテスト環境を作る用途も示されています。
モデル構成と評価
Atlasは、マルチモーダル自己回帰型拡散Transformerです。テキスト、画像、カメラ姿勢、3D深度マップを扱い、先行する要素を条件として次の要素を生成します。拡散方式には、段階的にノイズを除去するRectified Flowを採用しています。
World Labsの比較評価では、カメラ制御付き生成で第三者評価者がAtlasを選んだ割合は、比較モデルに応じて75〜94%でした。ただし、Atlasにはカメラ経路をネイティブ形式で入力し、比較モデルにはテキストで指示しています。
疎な入力画像からの3D再構築でも、同社の評価では専門モデルを上回りました。複数ベンチマークにおける平均の再構築誤差(AbsRel ×10⁻³、低いほど良い)は、Atlasが25.3、Pi3X(posed)が28.7でした。いずれもWorld Labsが公開した評価結果です。
提供状況
Atlasは現在、選定されたパートナー向けの早期アクセスとして提供され、利用希望者はWorld LabsのWebサイトから申請できます。今後のMarbleやWorld Labsのほかの製品にも採用される予定です。
