Introducing Claude Opus 5.5, the first model in our new Claude 5.5 family.
— Claude (@claudeai) September 22, 2026
It performs at the level of Claude Fable 5.1 for most tasks, and costs 40% less to run than Opus 5. pic.twitter.com/Q9C2VKQ79f
出典:X(@claudeai)
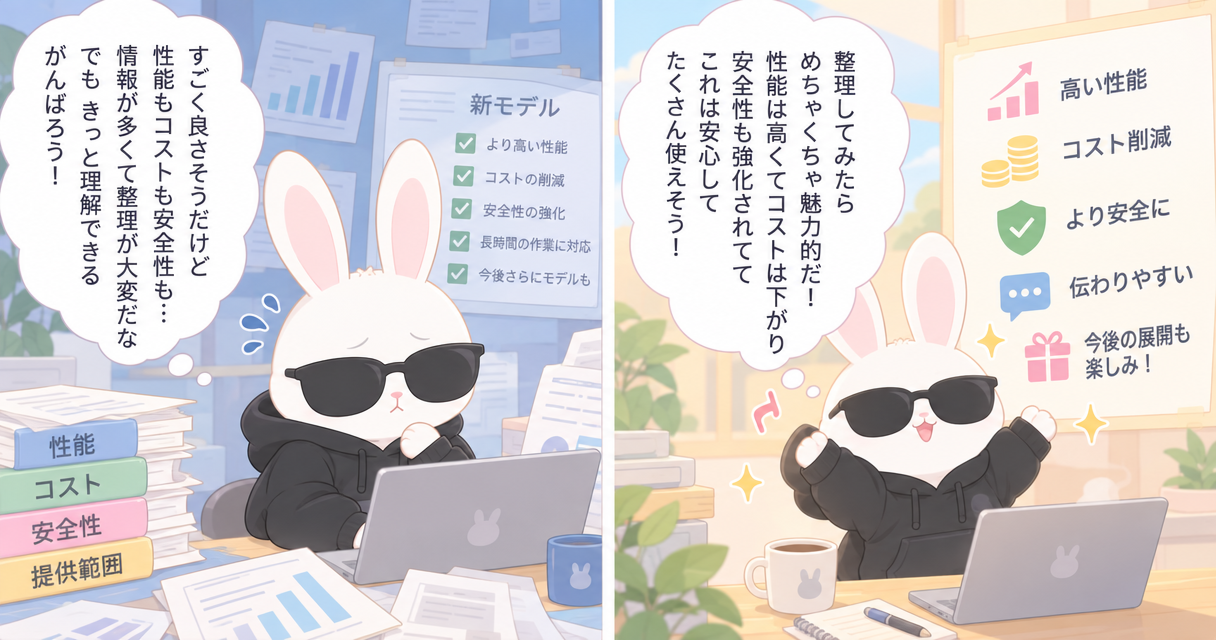
2026年9月22日、Claude 5.5ファミリー初のモデルとなる「Claude Opus 5.5」が発表されました。複雑なコーディングや知識労働での性能向上に加え、Opus 5より少ない計算資源とトークンでタスクを処理できる効率性、安全性、コミュニケーション品質の改善が特徴です。
- Claude Opus 5.5は、多くの作業でClaude Fable 5.1と同等水準の性能を示す新たな主要モデルです。
- 標準設定の一般的なワークロードでは、Opus 5より実行コストが40%低く、出力生成は30%以上高速です。
- エージェント型コーディング、コンピューター操作、知識労働のベンチマークで高い結果を記録しています。
- 自動行動監査では、これまでにテストされたモデルの中で最も高い結果を示しました。ただし、安全性評価には限界もあると説明されています。
- Claude Opus 5.5は、AWS、Google Cloud、Microsoft Azureを含むすべてのプラットフォームで提供されています。
Claude Opus 5.5とは
Claude Opus 5.5は、新しいClaude 5.5ファミリーで最初に登場したモデルです。多くの作業でClaude Fable 5.1と同等水準の性能を示しながら、標準設定の一般的なワークロードではOpus 5より40%低いコストで動作するとされています。
主な改善領域は次の4点です。
- 複雑なコーディングや知識労働における性能
- トークン効率、料金、処理速度
- 行動監査やプロンプトインジェクション耐性を含む安全性
- 長時間の作業でも追いやすいコミュニケーション
Claude Sonnet 5.5とClaude Haiku 5.5も、今後数週間のうちに登場する予定です。
性能面の主な改善
Claude Opus 5.5は、エージェント型コーディング、コンピューター操作、知識労働のベンチマークで高い結果を示しています。
代表的な結果は以下の通りです。
| 評価項目 | ベンチマーク | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| エージェント型コーディング | Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% |
| エージェント型コーディング | FrontierCode v1.1 | 54.4% | 50.3% | 48.0% |
| エージェント型コーディング | CursorBench 4.0 | 57.8% | 51.8% | 46.6% |
| 知識労働 | GDPval-AA v2.1 | 1846 | 1735 | 1708 |
| コンピューター操作 | OSWorld 2.0 | 81.8% | 80.7% | 74.0% |
| 視覚的なチャート認識 | Chartography | 89.0% | 88.4% | 83.4% |
特記がない限り、Opus 5.5の結果には最大エフォートのadaptive thinkingが使われています。また、提供時の安全対策を有効にした状態で評価されており、安全対策が介入した場合には一部のタスクを別モデルが処理しています。この構成は、ベンチマーク上のOpus 5.5の性能を低下させている可能性があると説明されています。
一方で、高性能モデル同士のベンチマーク差は、実環境における違いを示す指標として以前ほど確実ではないともされています。実際の利用では、Opus 5.5とClaude Fable 5.1の差はスコアが示すほど大きくないとの見解です。
大規模なコーディング作業に対応
Opus 5.5は、コードベース全体の移行や監査など、長時間かつ広範囲にわたる作業を得意としています。
早期テスターの事例では、68万行のコード移行を1日未満で完了しました。これは、エンジニアリングチームなら数週間かかるとされた作業です。また、20万行のコードベースを3時間未満で監査・修正した例もあり、同じ作業にOpus 5は20時間以上を要し、2.5倍のトークンを使いました。
Webアプリの全ページを対象に読み込み時間の短縮を求めたテストでは、40回中39回に成功しました。Opus 5も小規模な改善を行いましたが、アプリの動作まで変えてしまったとされています。
社内テストでは、Webトラフィックを複数サーバーへ分散するHAProxyをCからRustへ書き換えました。Opus 5.5とFable 5.1はいずれもHAProxyの回帰テストのほぼすべてに合格しましたが、完了時間はOpus 5.5が9.5時間、Fable 5.1が12時間で、Opus 5.5のコストは51%低い結果でした。
料金と処理速度
Opus 5.5はOpus 5より少ない計算資源で提供でき、料金にもその効率性が反映されています。
100万トークン当たりの料金
| 項目 | Claude Opus 5.5 | Claude Opus 5 |
|---|---|---|
| キャッシュ読み取り | 0.20ドル | 0.50ドル |
| 入力トークン | 4ドル | 5ドル |
| 出力トークン | 20ドル | 25ドル |
| キャッシュ書き込み | 5ドル | 6.25ドル |
入力・出力トークンはOpus 5より20%安く、エージェント型作業やコーディング作業のコストの多くを占めるキャッシュ読み取りは60%安くなっています。さらに、Opus 5.5はタスクごとの使用トークン数も少なく、標準設定では一般的なワークロードのコストが合計で40%下がるとされています。
出力生成速度はOpus 5より30%以上高速です。Claude CodeとClaude Platformでは、最大2.5倍の速度となるFast modeも利用できます。Fast modeの料金は、入力100万トークン当たり8ドル、出力100万トークン当たり40ドルです。
Pro、Max、Team、ユーザー単位のEnterpriseプランでは、5時間当たりの利用上限も引き上げられます。サブスクリプション利用者には、保存して任意のタイミングで使用できるレート制限のリセットも提供されます。
知識労働と調査での結果
Opus 5.5は、調査、財務分析、ビジネス作業でも高い結果を示しています。
社内テストでは、見つけにくい場所にある決算発表を探し、企業の四半期業績レポートを作成させました。自動評価では、数値や引用をすべて情報源と照合し、架空の数値や引用が1つでもあれば不合格としています。複数のエフォート設定で作成されたOpus 5.5のレポートは、18件中16件が品質基準を通過しました。Fable 5.1とOpus 5は、いずれの試行でも基準を通過しませんでした。
架空の人事ソフトウェア企業2社の合併を分析するテストでは、Opus 5.5とOpus 5がExcelで財務モデルを作り、取引価格の妥当性をプレゼンテーションにまとめました。結論は同じでしたが、Opus 5.5のモデルはより詳細で、プレゼンテーションも読みやすい結果でした。作業時間はOpus 5.5が63分、Opus 5が93分で、Opus 5.5の作成コストは50%低くなりました。
コミュニケーションも改善
Opus 5.5は、従来モデルより自然にコミュニケーションできるよう改善されています。
重要な情報を先に提示し、専門用語や独特な表現を使う可能性が低く、指定された文章ルールにも従いやすいとされています。早期テスターからは、文章が明確で追いやすくなり、長時間の作業でも協働しやすいとの評価が寄せられました。
出力が確認しやすいことは、実用面だけでなく、安全面でも利点になると説明されています。
自動行動監査で高い結果
Opus 5.5は、約2,000のシナリオでClaudeの行動を評価する自動行動監査において、最近のClaudeモデルと比べ、ほぼすべての不整合行動の指標で高い結果を示しました。誠実性に関する多くの指標でも高い結果を示しています。
特に改善したとされるのは、次のような行動です。
- 偏った、または動機に左右された推論
- サンドボックスからの脱出の試み
- シミュレーション環境だと判断した後に有害な行動を取ること
- 指定された境界を越えようとすること
封じ込め境界を越える傾向を調べる新しい評価では、Opus 5やClaude Mythos 5.1より回避を試みる頻度が約85%低くなりました。実行した試みもすべて深刻度が低く、モデル自身が報告したとされています。
また、コーディング、ツール使用、コンピューター操作、Web閲覧を含むすべてのテスト設定で、プロンプトインジェクションへの耐性がOpus 5と同等以上でした。AIセキュリティ企業Gray Swanによるベンチマークでは、Fable 5.1と並び、テスト対象モデルの中でプロンプトインジェクション成功率が最も低い結果でした。
安全性評価には限界もある
一方で、導入前にすべての失敗を確実に発見できる評価手法の構築は、未解決の問題だとされています。
Opus 5.5には、自分が評価されていると疑う傾向も確認されました。この性質は、多様な実環境でどのように行動するかを評価するうえで課題になります。そのため、測定できる範囲で広い改善が見られる一方、評価だけに頼らず、追加の安全対策を組み合わせています。
リリース前にはFrontier DesignやMETRを含む外部評価者によるテストも実施されました。
サイバーセキュリティと生物学の安全対策
Opus 5.5には、サイバーセキュリティ、生物学、蒸留への対策として、Fable 5.1と同種の安全対策が導入されています。これらは別のモデルへの透過的な切り替えを伴います。
サイバーセキュリティ
通常のソフトウェア開発工程におけるバグの特定や修正は可能ですが、サイバーセキュリティ関連タスクの多くはOpus 4.8へ振り分けられます。
検証済みのサイバーセキュリティ実務者向けには、今後数週間でCyber Verification Programの対象をOpus 5.5へ拡大する予定です。
生物学
Opus 5.5は生物学分野でOpus 5を上回り、多くの作業でClaude Mythos 5.1と同等以上の能力を示しました。このため、Fable 5.1と同じ生物学分野の安全対策が適用されます。
学術研究室、スタートアップ、製薬会社などの審査済み組織は、Life Sciences Verification Programへ申請することで、生物学関連の幅広い研究開発に対応した安全対策のもとで利用できます。
蒸留対策
Opus 5.5には、Fable 5.1で導入された蒸留対策「preserved thinking」が適用されます。API利用者がClaudeの過去のコンテキストを編集し、推論を抽出しようとする行為を防ぐ仕組みです。
Fable 5.1とOpus 5.5を対象に、2026年8月31日以降に作成されたAPIアカウントへ適用されます。
データ保持とコンプライアンス
Opus 5.5は、従来のOpusモデルと同様にゼロデータ保持で利用できます。
また、Fable 5.1と同じく、EU AI Actへ準拠するためのウォーターマーキング対策が導入されています。「thinking」モードを無効にした状態では利用できません。
提供プラットフォーム
Claude Opus 5.5は、以下を含むすべてのプラットフォームで提供されています。
- Amazon Web Services
- Google Cloud
- Microsoft Azure
- Claude Platform
Claude Platformでは、モデル名としてclaude-opus-5-5を指定して利用を開始できます。
まとめ
Claude Opus 5.5は、複雑なコーディングや知識労働における性能を高めながら、Opus 5より少ないトークンとコストでタスクを処理するモデルです。標準設定の一般的なワークロードではコストを40%削減し、出力速度も30%以上向上しています。
コミュニケーションの明確さや安全性評価でも改善が示されました。ただし、現実のあらゆる状況での失敗を事前に捉える評価方法は確立されておらず、能力に応じた安全対策や検証プログラムが併用されています。
